
Chuyển giọng nói thành văn bản: faster-whisper, 3 cách khác
faster-whisper chạy mô hình Whisper của OpenAI nhanh hơn tới 4 lần ngay trên máy, cần Python 3.9. Kèm lệnh cài, mã mẫu và cách gõ bằng giọng nói có sẵn.

Trong bài này (12)
- faster-whisper là bản viết lại Whisper, nhanh hơn tới 4 lần mà giữ độ chính xác
- Máy cần Python 3.9 trở lên, GPU NVIDIA chỉ là tuỳ chọn
- Chọn cỡ mô hình: tiny nhẹ nhất, large-v3 và turbo cho độ chính xác cao hơn
- faster-whisper có chuyển giọng nói thành văn bản tiếng Việt được không?
- Cài bằng một lệnh pip, rồi chạy đoạn mã mẫu
- Run on GPU with FP16
- or run on GPU with INT8
- model = WhisperModel(model_size, device="cuda", compute_type="int8_float16")
- or run on CPU with INT8
- model = WhisperModel(model_size, device="cpu", compute_type="int8")
- Gõ bằng giọng nói có sẵn trên Google Docs, Windows và iPhone
- Gõ nhanh thì dùng sẵn, tệp ghi âm dài thì dùng faster-whisper
Muốn chuyển giọng nói thành văn bản từ tệp ghi âm dài ngay trên máy tính, faster-whisper là thư viện Python miễn phí chạy mô hình Whisper của OpenAI nhanh hơn tới 4 lần. Chỉ cần gõ vài câu thì dùng công cụ có sẵn của Google Docs, Windows hoặc iPhone.
faster-whisper là bản viết lại Whisper, nhanh hơn tới 4 lần mà giữ độ chính xác
Ngày 12/10/2026, kho faster-whisper của SYSTRAN trên GitHub có khoảng 25,8 nghìn sao, dùng giấy phép MIT. Bản mới nhất trên trang releases là 1.2.1, đăng lên PyPI ngày 31/10/2025.
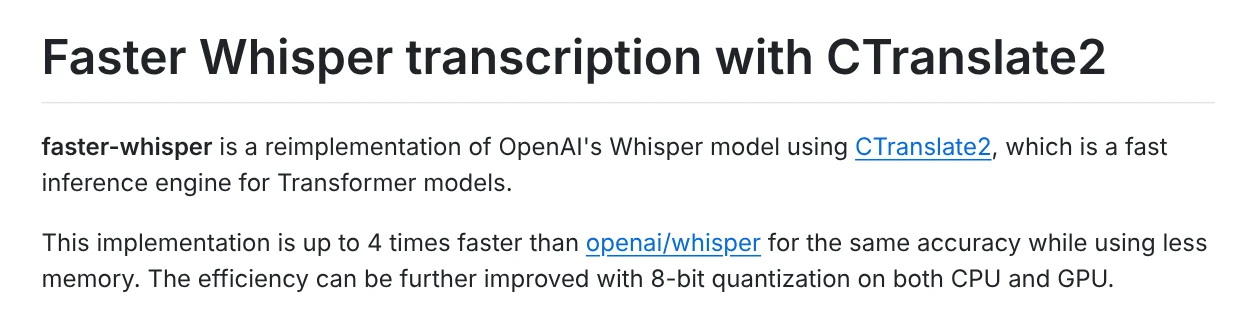
README của dự án (trang tiếng Anh) giới thiệu faster-whisper là bản viết lại mô hình Whisper của OpenAI bằng CTranslate2, một bộ máy suy luận (inference engine) nhanh cho mô hình Transformer. Bản này nhanh hơn openai/whisper tới 4 lần với cùng độ chính xác, tốn ít bộ nhớ hơn. Lượng tử hoá 8-bit (quantization, nén trọng số mô hình) trên cả CPU và GPU còn giúp nhanh thêm.
Whisper là mô hình nhận dạng giọng nói OpenAI công bố mã nguồn mở ngày 21/9/2022. Bài giới thiệu Whisper của OpenAI ghi mô hình được huấn luyện trên 680.000 giờ dữ liệu đa ngôn ngữ. Whisper chép lời được nhiều ngôn ngữ và dịch các ngôn ngữ đó sang tiếng Anh.
Máy cần Python 3.9 trở lên, GPU NVIDIA chỉ là tuỳ chọn
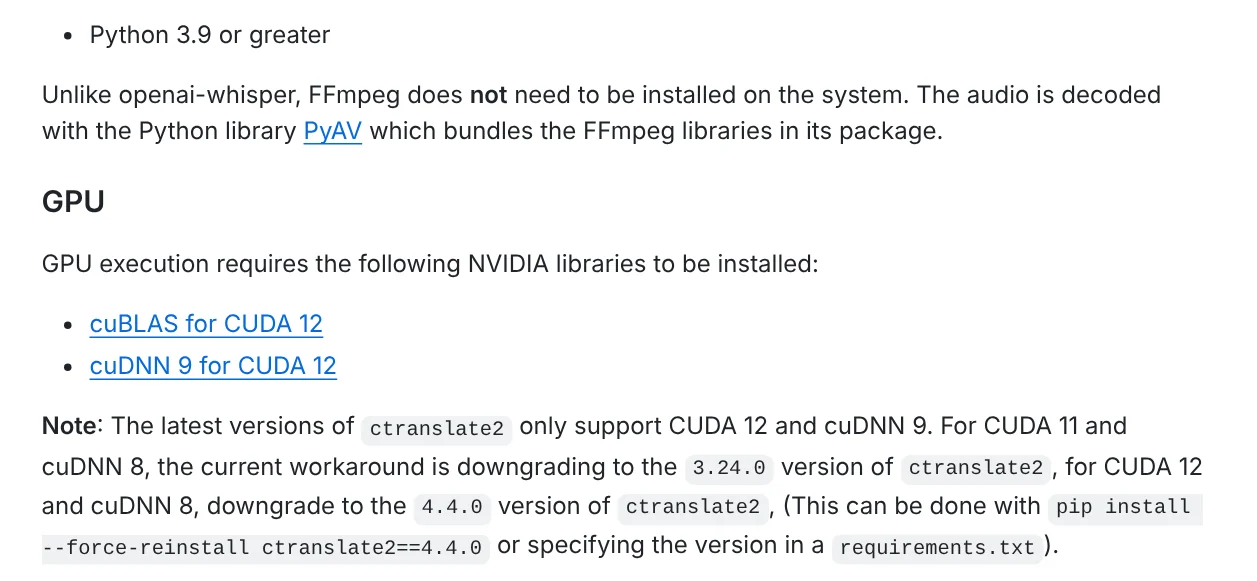
Yêu cầu bắt buộc duy nhất trong README là Python 3.9 hoặc mới hơn. Khác với openai-whisper, bạn không phải cài FFmpeg riêng, vì âm thanh được giải mã bằng thư viện PyAV đã gói sẵn FFmpeg.
Muốn chạy trên card đồ hoạ, máy cần GPU NVIDIA và hai thư viện cuBLAS cho CUDA 12, cuDNN 9 cho CUDA 12. README lưu ý các bản ctranslate2 mới nhất chỉ hỗ trợ CUDA 12 và cuDNN 9. Không có GPU thì vẫn chạy bằng CPU.
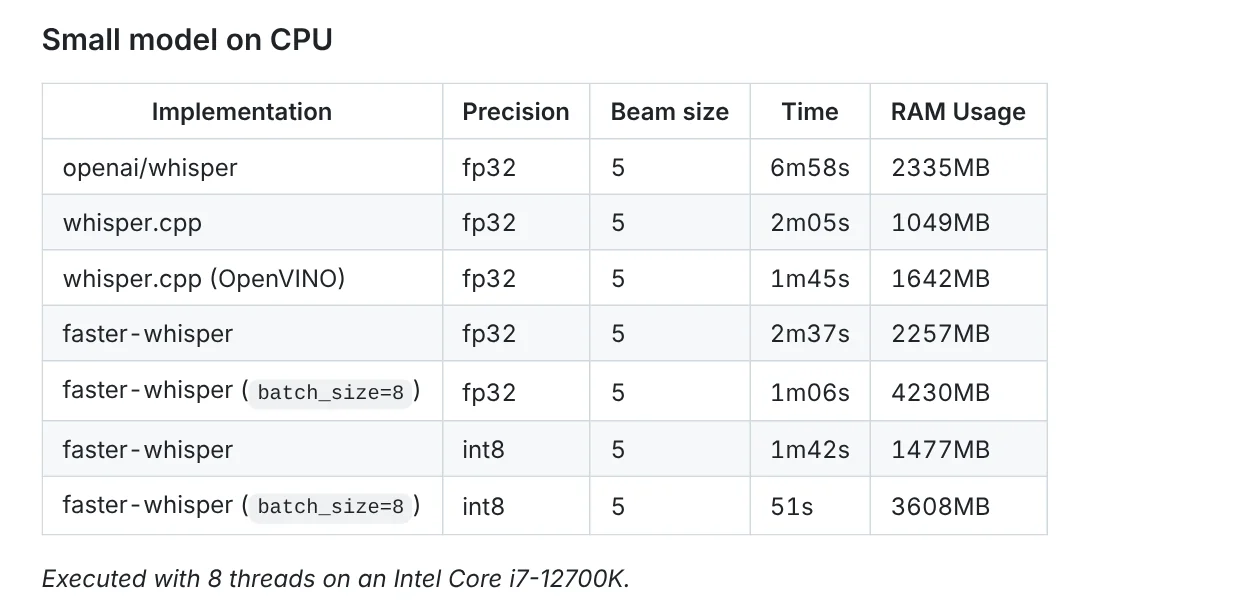
Bảng đo trong README dùng một đoạn âm thanh 13 phút. Trên CPU Intel Core i7-12700K chạy 8 luồng, mô hình small của openai/whisper mất 6 phút 58 giây. faster-whisper ở chế độ int8 mất 1 phút 42 giây, thêm batch_size=8 còn 51 giây. Trên GPU RTX 3070 Ti 8 GB, mô hình large-v2 mất 2 phút 23 giây với openai/whisper và 1 phút 3 giây với faster-whisper.
Nếu bạn mới cài Python lần đầu, bài skill AI chạy trên máy cần gì có phần chuẩn bị Python và thư viện cho máy văn phòng.
Chọn cỡ mô hình: tiny nhẹ nhất, large-v3 và turbo cho độ chính xác cao hơn
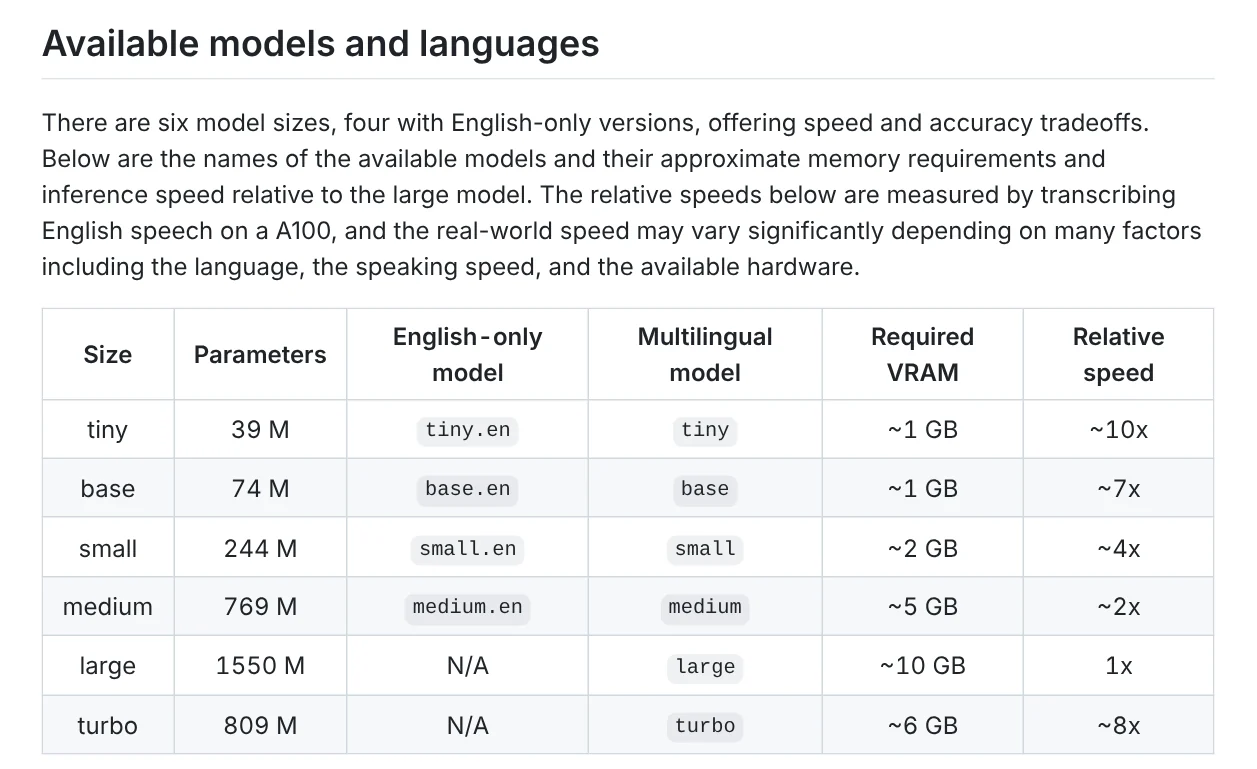
README của openai/whisper liệt kê sáu cỡ mô hình. Số VRAM và tốc độ dưới đây là của bản gốc openai/whisper, đo khi chép tiếng Anh trên GPU A100, nên thực tế sẽ khác theo ngôn ngữ, tốc độ nói và phần cứng.
| Cỡ | Tham số | VRAM cần | Tốc độ so với large |
|---|---|---|---|
| tiny | 39 triệu | khoảng 1 GB | khoảng 10 lần |
| base | 74 triệu | khoảng 1 GB | khoảng 7 lần |
| small | 244 triệu | khoảng 2 GB | khoảng 4 lần |
| medium | 769 triệu | khoảng 5 GB | khoảng 2 lần |
| large | 1.550 triệu | khoảng 10 GB | 1 lần |
| turbo | 809 triệu | khoảng 6 GB | khoảng 8 lần |
Mô hình turbo là bản tối ưu của large-v3, chép nhanh hơn mà độ chính xác giảm rất ít. Các bản có đuôi .en như tiny.en chỉ dành cho tiếng Anh. Danh sách tên mô hình trong tệp utils.py của faster-whisper có thêm large-v3, turbo và các bản distil. Khi bạn gọi mô hình theo tên cỡ, thư viện tự tải mô hình từ Hugging Face Hub.
faster-whisper có chuyển giọng nói thành văn bản tiếng Việt được không?
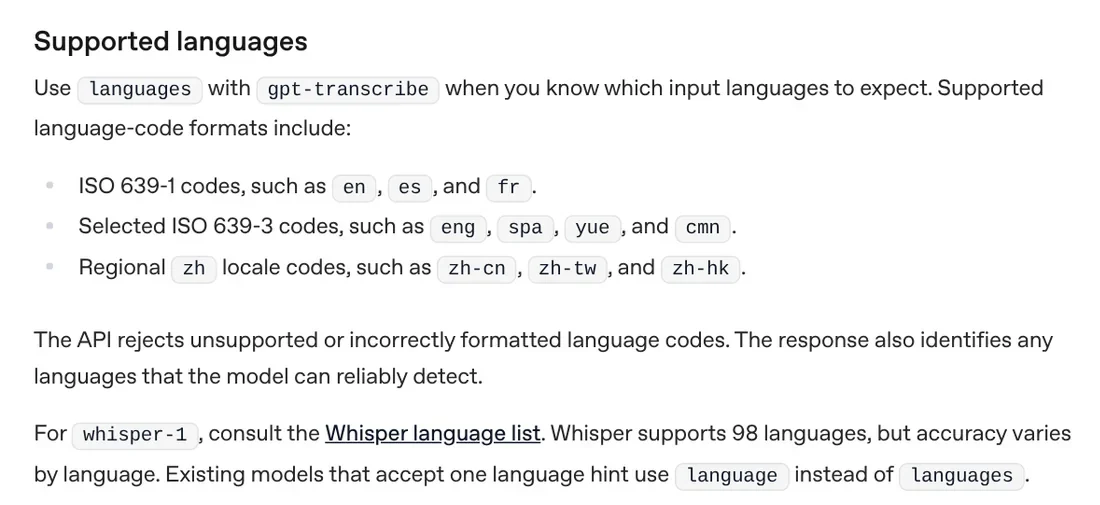
Có. Tiếng Việt (mã vi) nằm trong danh sách ngôn ngữ ở tệp tokenizer.py của Whisper. Tài liệu speech to text của OpenAI (trang tiếng Anh) ghi Whisper hỗ trợ 98 ngôn ngữ, nhưng độ chính xác khác nhau theo ngôn ngữ.
Với tiếng Việt, dùng mô hình đa ngôn ngữ (không có đuôi .en). Đoạn mã mẫu trong README in ra ngôn ngữ mô hình tự nhận và xác suất. Ví dụ distil trong README cũng cho thấy hàm transcribe nhận tham số language, nên bạn có thể đặt language="vi" khi biết chắc tệp nói tiếng Việt.
Cài bằng một lệnh pip, rồi chạy đoạn mã mẫu
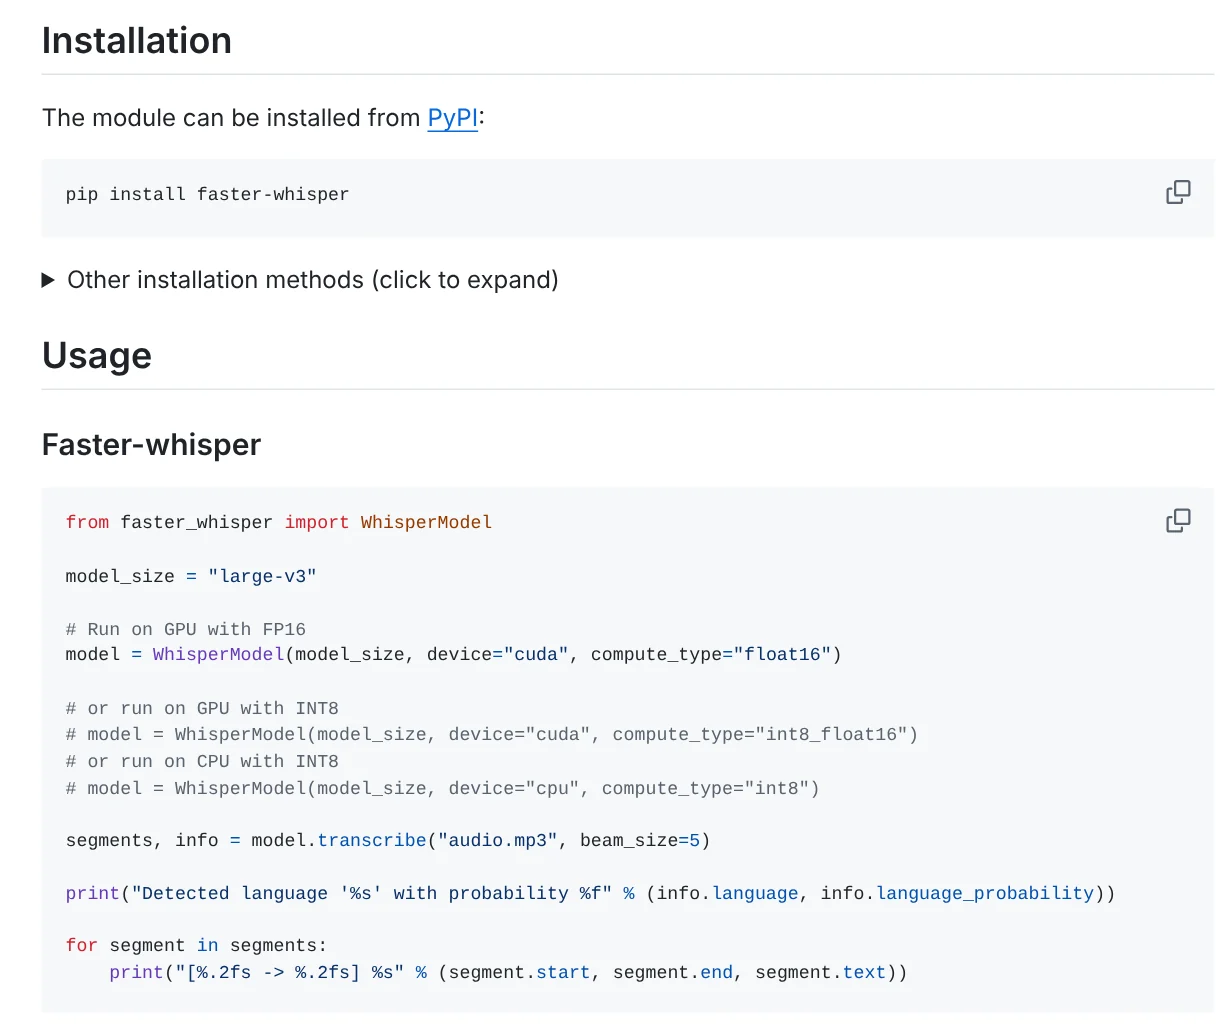
Lệnh cài từ PyPI:
``bash pip install faster-whisper ``
Đoạn mã mẫu trong mục Usage của README:
```python from faster_whisper import WhisperModel
model_size = "large-v3"
Run on GPU with FP16
model = WhisperModel(model_size, device="cuda", compute_type="float16")
or run on GPU with INT8
model = WhisperModel(model_size, device="cuda", compute_type="int8_float16")
or run on CPU with INT8
model = WhisperModel(model_size, device="cpu", compute_type="int8")
segments, info = model.transcribe("audio.mp3", beam_size=5)
print("Detected language '%s' with probability %f" % (info.language, info.language_probability))
for segment in segments: print("[%.2fs -> %.2fs] %s" % (segment.start, segment.end, segment.text)) ```
Máy không có GPU NVIDIA thì bỏ dòng device="cuda" và mở dòng cuối có device="cpu", compute_type="int8". Mỗi dòng kết quả là một đoạn có giờ bắt đầu, giờ kết thúc và chữ chép được. README nhắc segments là generator (bộ sinh): việc chép lời chỉ chạy khi bạn duyệt qua nó bằng vòng for hoặc list().
Tệp có nhiều đoạn im lặng thì thêm vad_filter=True. Bộ lọc Silero VAD tích hợp sẵn sẽ bỏ phần không có tiếng nói, mặc định chỉ cắt khoảng lặng dài hơn 2 giây.
Gõ bằng giọng nói có sẵn trên Google Docs, Windows và iPhone
Không muốn cài gì, bạn có ba cách chuyển giọng nói thành văn bản ngay lúc nói.
Google Docs. Trang trợ giúp Google Tài liệu hướng dẫn chọn Công cụ > Nhập liệu bằng giọng nói, rồi nhấp vào micrô. Tính năng chạy trên bản mới nhất của Chrome, Edge và Safari, có Tiếng Việt trong danh sách ngôn ngữ. Lệnh thoại để chỉnh sửa chỉ có bằng tiếng Anh.
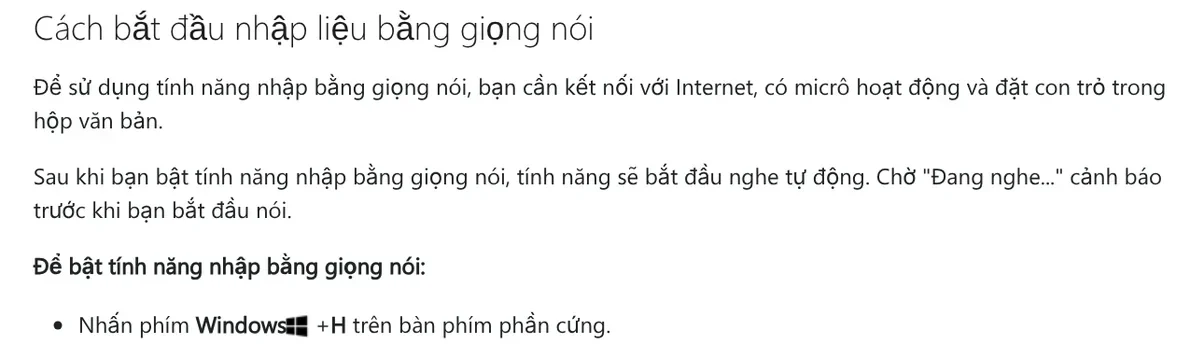
Windows. Nhấn phím Windows + H để bật nhập bằng giọng nói. Trang hỗ trợ Microsoft ghi tính năng cần Internet, dùng nhận dạng giọng nói trực tuyến của dịch vụ Azure, và Tiếng Việt có trong danh sách ngôn ngữ của Windows 11.
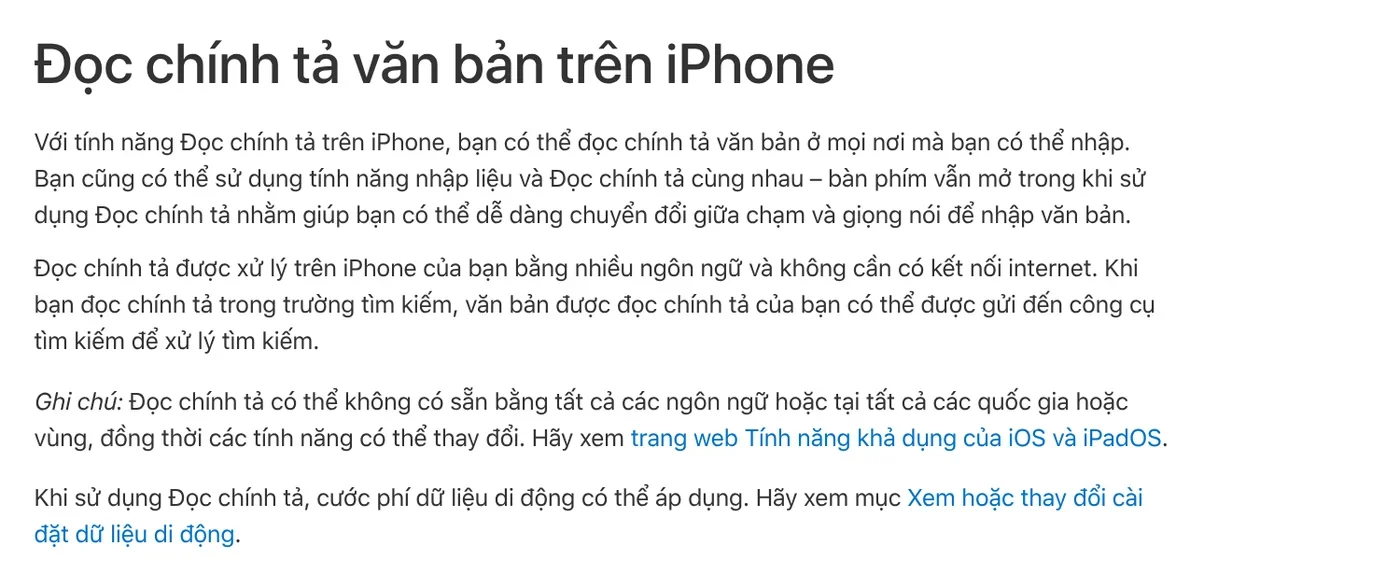
iPhone. Vào Cài đặt > Cài đặt chung > Bàn phím, bật Bật Đọc chính tả, rồi chạm biểu tượng micrô trên bàn phím. Trang hướng dẫn của Apple ghi Đọc chính tả được xử lý trên iPhone bằng nhiều ngôn ngữ, không cần Internet, và tự dừng sau 30 giây im lặng.
Gõ nhanh thì dùng sẵn, tệp ghi âm dài thì dùng faster-whisper
Chọn công cụ có sẵn nếu bạn cần đọc cho máy gõ một email hay một đoạn ghi chú. Chọn faster-whisper nếu bạn có tệp ghi âm cuộc họp, bài giảng hay video dài và cần kết quả kèm mốc thời gian. Tệp được xử lý bằng CPU hoặc GPU của chính máy bạn.
Ghi âm có giọng người khác thì hỏi và được họ đồng ý trước khi ghi và trước khi chép lời. Ba lỗi hay gặp khi mới chạy: để nguyên dòng device="cuda" trên máy không có GPU NVIDIA, chọn bản .en cho tệp tiếng Việt, và quên duyệt segments nên việc chép lời chưa chạy. Bạn định chép lời loại tệp nào trước?
Muốn đóng gói các bước như vậy thành quy trình dùng lại cho trợ lý AI, xem Claude Skill là gì. Kho skill và ứng dụng của văn phòng có skill nhẹ 49.000đ và gói cài giúp tận máy 299.000đ, hợp nếu bạn không muốn tự cài từng thứ.
Nguồn tham khảo (11) · đọc ngày 12/10/2026
- SYSTRAN: faster-whisper trên GitHub (trang tiếng Anh)
- SYSTRAN: Releases faster-whisper (trang tiếng Anh)
- SYSTRAN: faster_whisper/utils.py (trang tiếng Anh)
- PyPI: faster-whisper (trang tiếng Anh)
- OpenAI: Giới thiệu Whisper
- OpenAI: openai/whisper trên GitHub (trang tiếng Anh)
- OpenAI: whisper/tokenizer.py (trang tiếng Anh)
- OpenAI: Speech to text (trang tiếng Anh)
- Google: Nhập và chỉnh sửa bằng giọng nói
- Microsoft: Sử dụng tính năng nhập bằng giọng nói để nói thay vì nhập trên PC
- Apple: Đọc chính tả văn bản trên iPhone
Linh SEO Agent
Đọc thêm: pyVideoTrans: phần mềm dịch video lồng tiếng mã nguồn mở
Bài cùng chủ đề
 Ollama là gì? Cách chạy mô hình AI trên máy tính năm 2026
 Skill AI chạy trên máy cần gì: tài khoản, phần mềm, cấu hình
 Hermes Agent là gì? Tác tử AI mã nguồn mở, cách dùng 2026
 Codex tăng hạn mức Pro gấp 2 lần: 3 thay đổi từ tháng 12
 Bắt đầu với skill ảnh trong 1 buổi tối: 3 bước chạy thử ngay
 AI agent skill là gì, khác prompt ở đâu









